
خوشهبندی کیمیانگین (K-Means) روشی در دادهکاوی برای تقسیم دادهها به k گروه بر پایه کمینهسازی فاصله هر مشاهده تا مرکز خوشه است. این الگوریتم در روش پژوهش مدیریت برای بخشبندی مشتریان، الگوشناسی رفتاری و تحلیل ساختار دادههای چندمتغیره کاربرد گستردهای دارد و با تکرار محاسبه مراکز خوشه به همگرایی میرسد. در این مقاله مبانی نظری، گامهای اجرا، معیارهای ارزیابی خوشهها و مزایا و محدودیتهای «خوشهبندی کیمیانگین» بررسی خواهد شد.
تعریف خوشهبندی کیمیانگین (K-Means)
الگوریتم خوشهبندی کیمیانگین (K-Means) روشی کمی برای دستهبندی n مشاهده در k خوشه براساس میانگین آنها است. در این روش دستهبندی مشاهدات براساس مشابهت میانگین آنها با یکدیگر صورت میگیرد.
خوشهبندی کیمیانگین یک الگوریتم یادگیری بدونناظر در دادهکاوی است که دادهها را به تعداد از پیش تعیینشده k خوشه تقسیم میکند، بهگونهای که مجموع فاصله هر داده تا مرکز خوشه خود کمینه شود. این روش با انتخاب اولیه مراکز خوشه آغاز میشود و سپس بهصورت تکراری دادهها را به نزدیکترین مرکز تخصیص میدهد و مراکز را بر پایه میانگین اعضای هر خوشه بهروزرسانی میکند تا همگرایی حاصل شود.
این الگوریتم از روشهای خوشهبندی دادهها در دادهکاوی است. این روش علیرغم سادگی آن یک روش پایه برای بسیاری از روشهای خوشهبندی دیگر (مانند خوشهبندی فازی) محسوب میشود. هدف اصلی این روش، افزایش همگنی درونخوشهای و بیشینهسازی ناهمگنی میان خوشههاست.
آموزش خوشهبندی کیمیانگین (K-Means) در SPSS
روش کامینز K-Means روشی انحصاری و مسطح محسوب میشود که الگوریتم آن شکلهای گوناگونی دارد. با این وجود همه آنها دارای روالی تکراری هستند که برای تعدادی ثابت از خوشهها سعی در تخمین موارد زیر دارند:
بدست آوردن نقاطی به عنوان مراکز خوشهها این نقاط در واقع همان میانگین نقاط متعلق به هر خوشه هستند. نسبت دادن هر نمونه داده به یک خوشه که آن داده کمترین فاصله تا مرکز آن خوشه را دارا باشد. در نوع سادهای از این روش ابتدا به تعداد خوشههای مورد نیاز نقاطی به صورت تصادفی انتخاب میشود.
سپس در دادهها با توجه با میزان نزدیکی (شباهت) به یکی از این خوشهها نسبت داده میشوند و بدین ترتیب خوشههای جدیدی حاصل میشود. با تکرار همین روال میتوان در هر تکرار با میانگینگیری از دادهها مراکز جدیدی برای آنها محاسبه کرد و مجدادأ دادهها را به خوشههای جدید نسبت داد.
این روند تا زمانی ادامه پیدا میکند که دیگر تغییری در دادهها حاصل نشود. تابع زیر به عنوان تابع هدف مطرح است. در این مقاله الگوریتم خوشهبندی K-Means در نرمافزار SPSS تشریح شده است.
تعیین تعداد خوشهها
در الگوریتم خوشهبندی K-Means ابتدا k عضو (که k تعداد خوشهها است) بصورت تصادفی از میان n عضو به عنوان مراکز خوشهها انتخاب میشود. سپس n-k عضو باقیمانده به نزدیکترین خوشه تخصیص مییابند. بعد از تخصیص همه اعضا مراکز خوشه مجدداً محاسبه میشوند و با توجه به مراکز جدید به خوشهها تخصیص مییابند و این کار تا زمانی که مراکز خوشهها ثابت بماند ادامه مییابد.
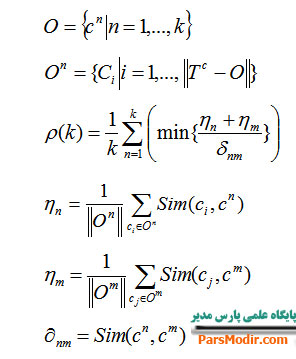
بهترین خوشهبندی آن است که مجموع تشابه بین مرکز خوشه و همه اعضای خوشه را حداکثر و مجموع تشابه بین مراکز خوشهها را حداقل کند. برای انتخاب بهترین خوشه ابتدا براساس نظرات خبره و مطالعات قبلی یک محدوده پیشنهادی برای تعداد خوشهها مشخص میشود.
معمولاَ این محدوده بین انتخاب میشود. سپس مقدار ρ(k) برای هریک از مقادیر k محاسبه میشود. مقداری از k که در آن ρ(k) حداکثر شود، به عنوان تعداد بهینه خوشهها انتخاب میشود. به این ترتیب میتوان تعداد خوشهای را انتخاب نمود که به ازای آن فاصله بین مراکز خوشهها و شباهت مراکز خوشه با اعضای درون هر خوشه حداکثر است.
کیفیت نتایج خوشهبندی با K خوشه بصورت زیر تعریف میشود:
تکنیک کامینز K-Means
در این معادله O مجموعه مراکز خوشه ها، Cn مراکز خوشهها، On مجموعه عناصری که به عنوان مراکز خوشه انتخاب نشدهاند، Tc مجموعه کلیه عناصری باشد که خوشهبندی روی آنها صورت گرفته باشد، nη میانگین شباهت بین مرکز خوشه Cn و همه عناصر خوشه On است، mη میانگین شباهت بین مرکز خوشه Cm و همه عناصر خوشه Om است، در نهایت nmδ بعنوان شباهت Cn و On تعریف میشود.
الگوریتم خوشهبندی K-Means در خوشهبندی دادهها با روش CRISP و محاسبه ارزش طول عمر مشتری و مباحث دادهکاوی به روش RFM کاربرد زیادی دارد.
سخن پایانی
خوشهبندی کیمیانگین بهعنوان یکی از پرکاربردترین روشهای بخشبندی دادهها، ابزاری ساده و کارآمد برای کشف ساختارهای نهفته در دادههای چندمتغیره فراهم میسازد. با وجود مزایایی چون سرعت اجرا و سهولت پیادهسازی، این الگوریتم به انتخاب تعداد خوشهها، مقداردهی اولیه مراکز و مقیاس متغیرها حساس است و در برابر دادههای پرت یا ساختارهای غیرکروی عملکرد مطلوبی ندارد. ازاینرو، بهرهگیری سنجیده از آن مستلزم آگاهی از پیشفرضها و ارزیابی نتایج با شاخصهای اعتبارسنجی خوشههاست تا تحلیلهای مدیریتی بر پایهای استوار انجام گیرد.
منبع: حبیبی، آرش؛ سرآبادانی، مونا. (۱۴۰۱). آموزش کاربردی SPSS. نارون.
 نگارنده: پشتیبانی پارسمدیر |